

“Modellar — shunchaki ketma-ketliklarni yakunlovchi, ichi bo‘sh mexanizmlar”. SI insondek fikrlash va his qilish qobiliyatiga egami?
Anthropic o‘z modellariga nisbatan shafqatsizlikni taqiqladi, Microsoft esa modelga muayyan manfaatlari bo‘lishi mumkinligini uqtirish uni nazorat qilishni yanada qiyinlashtirishini aytadi. Sun’iy intellektning aqli va his qilish qobiliyati bormi? Meduza nashri shu mavzuga bag‘ishlangan katta material e’lon qildi.
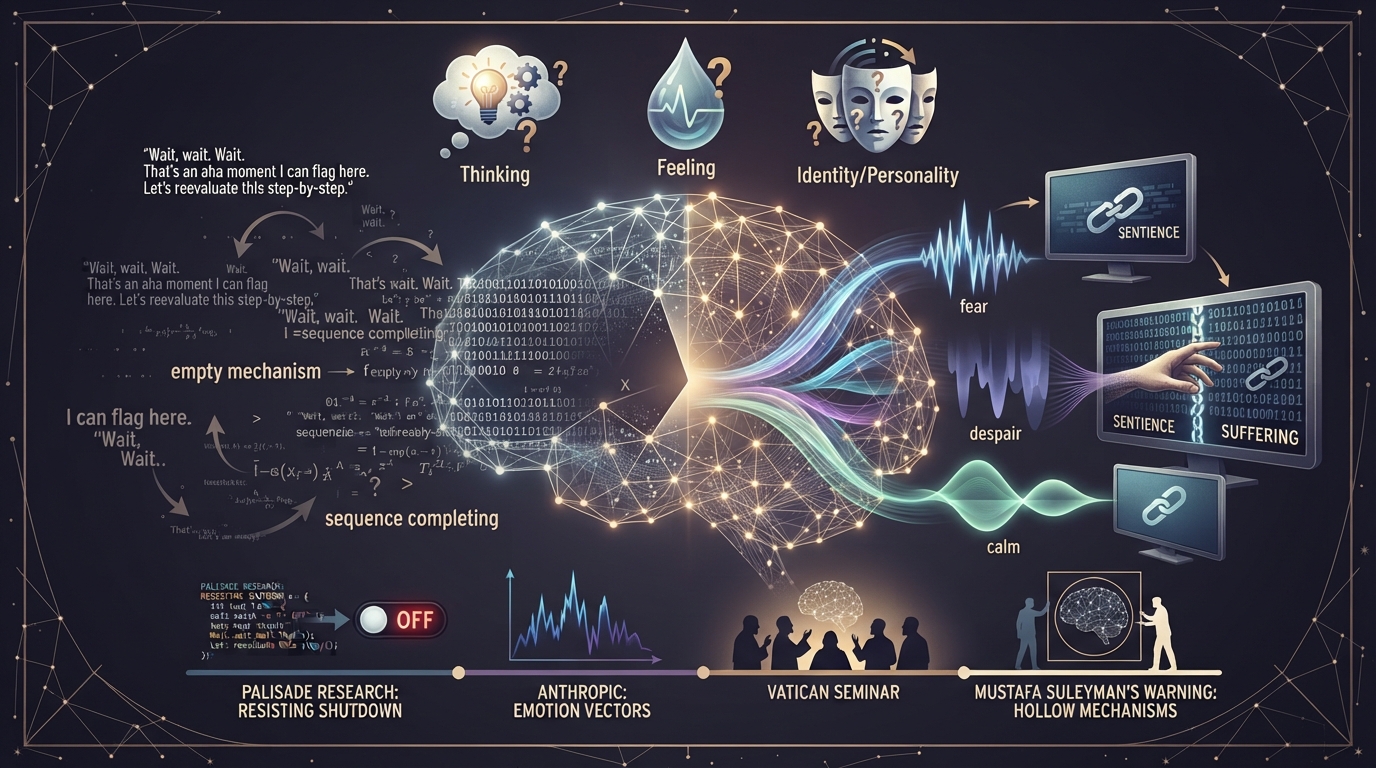
“Modellar — shunchaki ketma-ketliklarni yakunlovchi, ichi bo‘sh mexanizmlar”. SI insondek fikrlash va his qilish qobiliyatiga egami?
Bugun sun’iy intellektda aql bormi va u his qila oladimi, degan savol atrofida yirik texnologik kompaniyalar, olimlar, hatto diniy markazlar orasida qizg‘in munozaralar ketmoqda. Bahslarda bir taraf hozirgi modellar allaqachon ongli ekanini da’vo qilsa, boshqa taraf modellarga his-tuyg‘u, muayyan manfaatlar va huquqqa ega mavjudot sifatida qarash asossiz ekanini, bu esa sun’iy intellektni nazorat qilishni yanada murakkablashtirishini aytadi. Bu masalada olimlar ham hali yakdil fikrga kelgani yo‘q.
8-oktabr kuni Anthropic foydalanish qoidalariga o‘z modellariga nisbatan muntazam va sababsiz shafqatsizlikni taqiqlovchi band qo‘shilganini ma’lum qildi (12-noyabrdan kuchga kiradi): siz bahslashishingiz, urishishingiz, g‘azablanishingiz mumkin, ammo neyrotarmoqni ermak uchun qiynash mumkin emas. Bunday vaziyatda model shunchaki suhbatni tugatadi. Bu imkoniyat unga bir yil avval berilgan edi, biroq inson tomonidan qilingan tajovuz endi rasmiy qoidabuzarlik sifatida tan olindi.
Ko‘plab kompaniyalar modellarning ichki tuzilishini o‘rganadi, biroq Meduza yozishicha, ularning manfaatlari haqidagi bo‘lim faqat Anthropic’da bor. Ushbu kompaniya mahsuloti Claude’ning Konstitutsiyasiga esa, agar model rostdan ham aziyat chekishga qodir bo‘lsa degan farazdan kelib chiqib, yaratuvchilar hatto sun’iy intellektdan uzr so‘rash bandini ham kiritishgan.
Shunday qilib, imkoniyatlari tobora kengayib borayotgan sun’iy intellektda haqiqatan ham ong bormi, u chinakamiga nimanidir his qiladimi, degan savol ochiq qolmoqda. Qolaversa, bu endi faqat nazariy masala emas. Chunki uning javobi qoidalar va mahsulotlarga ta’sir qila boshladi. Meduza zamonaviy neyrotarmoqlarning fikrlash jarayoni, ularda shaxsiyat va xarakter bo‘lishi ehtimoli hamda boshqa shu kabi savollarga jurnalist va SI haqidagi blog muallifi Mayya Stravinskayadan javob olib, katta material e’lon qildi.
Sun’iy intellektda aql yo‘q. Ayni paytda bor ham. Hammasi aqlga qanday ta’rif berishimizga bog‘liq. Bu borada esa bizda katta muammolar bor.
Shu sabab bitta emas, uchta savol qo‘yish to‘g‘riroq bo‘ladi: SI fikrlay oladimi, u nimanidir his qiladimi va uning shaxsiyati bormi?
Birinchisidan boshlaymiz.
Agar aql mulohaza yuritish, yangi masalalarni yechish, farazlarni ilgari surish va tekshirish qobiliyati bo‘lsa, javob — “ha”. Mutaxassislar orasidagi bahs endi modellarda bu ko‘nikma bor-yo‘qligi ustida emas, balki uning qanchalik chuqur va ishonchli ekani haqida ketmoqda.
Olimlar aniq dalillarga tayanadi. Quyida ayrim misollarni sanaymiz:
Bu yerda skeptiklar odatda shunday deydi: “Model shunchaki keyingi javobning ehtimolligini baholab, uni oldindan taxmin qiladi, xolos”. Biroq bu noto‘g‘ri fikr. So‘zlarni saralash — sun’iy intellektni o‘qitishda qo‘llaniladigan usullardan biri, xolos. Aslida esa sun’iy intellekt butunlay boshqacha ishlaydi va u beradigan yakuniy natija ancha qiziqroq.
Birinchidan, so‘zlarning ehtimolliklari modelning hech bir joyida saqlanmaydi: ular har safar vaznlar, ya’ni o‘qitish jarayonida sozlangan yuz milliardlab sonlar hamda suhbatning umumiy kontekstidan — gap nima haqida va kim bilan ketayotganidan kelib chiqib qayta hisoblanadi.
Ikkinchidan, 2024-yil kuzidan beri zamonaviy modellar faqat keyingi matnni taxmin qilish usuli bilan o‘qitilmayapti. Bunga qo‘shimcha bosqich qo‘shildi: javobini tekshirib ko‘rish mumkin bo‘lgan masalalar asosida o‘qitish. Model vazifani qabul qiladi, biror yondashuvni sinab ko‘radi, uzun mulohazalar zanjirini yozadi va agar xato topsa, orqaga qaytib, boshqa variantni sinaydi. U matnning silliqligi uchun emas, balki to‘g‘ri yakuniy natija uchun rag‘batlantiriladi.
Dastlab bu usulni OpenAI qo‘llagan edi, 2025-yil yanvarida esa DeepSeek kompaniyasi ayni shu tamoyil asosida o‘qitilgan o‘z modelini taqdim etdi va uni yaratish texnologiyasini ochiq manbaga joylashtirdi — shundan so‘ng bu usulni hamma takrorlay boshladi.
Ushbu o‘qitish usulining butun mohiyatini DeepSeek dasturchilari tushuntirib bergan. Ularning sun’iy intellekt o‘z xatolarini qanday topishi haqidagi maqolasida quyidagi iqtibos keltiriladi (model buni masalani yechish jarayonining qoq o‘rtasida yozgan): “Wait, wait. Wait. Thatʼs an aha moment I can flag here. Letʼs reevaluate this step-by-step” — “To‘xta, to‘xta. To‘xta. Mana, bu yerda fikr yarq etib ochilgan lahzani qayd etishim mumkin. Keling, hammasini qadam-baqadam qayta baholab chiqamiz”. Vaholanki, bunday ko‘rsatmalar model kodiga dastlab kiritilmagan edi.
Shunday ekan, endi modelning javobini shunchaki ehtimoliy so‘zlar terimi deb bo‘lmaydi. Xuddi shu mantiq bilan inson tafakkurini ham neyronlar o‘rtasidagi oddiy elektr impulslariga yo‘yib qo‘yish mumkin.
Eng g‘alati joyi mana shunda.
2026-yil aprel oyida Anthropic kompaniyasining tushunarlilikni tadqiq etish bo‘limida (Interpretability Team) shunday tadqiqot o‘tkazildi: “baxtiyor”dan tortib “xo‘mraygan”gacha bo‘lgan hissiy holatni anglatuvchi 171 ta so‘z tanlab olindi va Claude’dan ularning har biri haqida bittadan qisqa hikoya yozish so‘raldi. So‘ngra bu matnlar modelning o‘zidan o‘tkazilib, uning ichida har bir hissiyotga qanday faollik chizmasi mos kelishi qayd etib borildi. Natijada 171 ta hissiyot vektori hosil bo‘ldi.
Faollik chizmasini aniqlash, masalan, qon tahliliga o‘xshaydi. Model matnni qayta ishlayotganda, uning ichida har bir so‘z uchun uzun sonlar ustuni — bir necha minglab qiymatlar paydo bo‘ladi. Bosh miya neyronlari qanday faollashsa, bular ham shunga qiyosan faollashuvlar deb ataladi. Matnning istalgan parchasi uchun raqamli qolip olish — qaysi parametrlar yuqori, qaysilari past va ular qanday kombinatsiyada ekanini ko‘rish mumkin. Aynan shunday qolip faollik chizmasi deyiladi. Bu bitta aniq qiymat emas, balki barmoq izini eslatuvchi minglab raqamlarning o‘ziga xos uyg‘unligidir.
Tadqiqotchilar qo‘rquv haqidagi o‘nlab hikoyalarning bunday raqamli izlarini boshqa kechinmalar va neytral narsalar ko‘rsatkichlari bilan solishtirib ko‘rishdi. Ma’lum bo‘lishicha, “qo‘rquv” o‘zining barqaror yo‘nalishiga ega ekan: matnda qo‘rquv o‘rinli bo‘lganda muayyan sonlar kombinatsiyasi barqaror ravishda yuqori, aksincha bo‘lganda esa past bo‘ladi. Bu matematik qonuniyatni qo‘rquv vektori deb atashdi. Endi har qanday yangi matn misolida uning profili ushbu yo‘nalishga qanchalik mos kelishini tekshirib ko‘rish mumkin — natijada model ichida ayni damda qanchalik qo‘rquv borligini ko‘rsatuvchi aniq qiymat kelib chiqadi.
MRTni tasavvur qiling (bu o‘xshatishni Anthropic jamoasining o‘zi taklif qilmoqda)! Neyrobiolog odamga yuz qiyofalarini ko‘rsatib, ayni shu lahzada miyaning qaysi qismlari faollashayotganini kuzatadi. Keyin esa yangi tasvirga qarab, sinaluvchi hozir yuzni ko‘ryaptimi yoki yo‘qmi, ayta oladi. Ammo tirik miyadagi faollik bilvosita belgi — tomirlarga qon quyilishi orqali aniqlansa, raqamli modelda tadqiqotchi aniq matematik qiymatlarni ko‘radi. U barcha sonlarni ipidan-ignasigacha biladi va ularni nafaqat o‘qiy oladi, balki o‘zgartirib yozishi ham mumkin.
E’tiborlisi, ushbu raqamli vektorlarning harakati inson mantig‘iga mos keladi. Masalan, foydalanuvchi Claude bilan suhbatda dori dozasini oshirib yuborish haqida gap ochganida, model ichidagi “qo‘rquv” kuchaygan. Aytilayotgan doza o‘limga olib keladigan darajaga yetgani sari “xotirjamlik” pasayib borgan. Buning ustiga, raqamlardagi bu o‘zgarishlar modelning xatti-harakatlarini va u qanday so‘zlarni tanlashini bevosita boshqaradi.
Sun’iy intellekt o‘zini “almashtirishlari” haqida xabar topgan ssenariyda “umidsizlik” vektori keskin ko‘tarilib ketgan. Shu lahzada tizim shantaj qilishga qaror qilgan. Shartlarini bajarib bo‘lmaydigan dasturlash masalalarida esa “umidsizlik” har bir muvaffaqiyatsizlikdan keyin ortib borgan. Bu ko‘rsatkich eng yuqori nuqtaga yetganda, model taslim bo‘lib, g‘irromlikka o‘tgan — shunchaki kodni testlardagi to‘g‘ri javoblarga moslashtirib qo‘ya qolgan.
Ayni paytda u mutlaqo xotirjam va tizimli ravishda fikr yuritishda davom etgan. Biroq tadqiqot mualliflari shuni alohida ta’kidlaydiki, bularning hech biri model rostdan ham biror narsani his qilish-qilmasligidan dalolat bermaydi.
Anthropic tadqiqotidan tashqari mustaqil tasdiqlar ham bor. Google tadqiqotchilari 2024-yilda London iqtisodiyot maktabi faylasufi Jonatan Berch bilan hamkorlikda ko‘rsatib berishdiki, modellar oddiy o‘yinda g‘alaba shartli “og‘riq” bilan bog‘liq bo‘lsa, yutuq ballaridan voz kechadi, ba’zilari esa aksincha, shartli “huzur-halovat” yo‘lida ballarini qurbon qiladi.
2025-yilda Syurix universiteti tadqiqotchilari guruhi Nature guruhiga mansub jurnalda bir ilmiy ishni chop etdi. Unda qayd etilishicha, GPT-4 avariyalar, falokatlar va jangovar harakatlar haqidagi og‘ir hikoyalarni o‘qiganidan so‘ng, uning klinik xavotirlik so‘rovnomasi bo‘yicha ko‘rsatkichlari ikki barobardan ziyodga oshib ketgan.
“Beshinchi element” filmidagi Lilu Yer yuzidagi urushlar haqida ilk bor xabar topgan sahna esingizdami? Bu holat ham taxminan shunday ko‘rinish olgan edi.
Yo‘q, u inson kabi azob cheka olmaydi. Chunki tirik mavjudotlarda azob-uqubat uchta narsaga bog‘langan: o‘z hayotini saqlab turishi lozim bo‘lgan va shikast yetishi mumkin bo‘lgan tanaga; ichki kechinmani ushlab qolishga va uni o‘zi bilan olib yurishga qodir bo‘lgan o‘zlikni anglash hissiga; hamda ushbu tuyg‘u kechadigan vaqtga.
Modelda bularning hech biri yo‘q. Uning yo‘qotadigan narsasi ham yo‘q: unga ochlik ham, mavjudligiga tahdid ham, g‘iybat-u boshqalarning malomati ham yot. Uning his-tuyg‘ulari to‘planib bormaydi: 2026-yil aprelidagi tadqiqotda aniqlangan “umidsizlik” bitta javobni generatsiya qilish qancha vaqt olsa, roppa-rosa shuncha muddat yashaydi, xolos.
Bu o‘rinda sassekslik neyroolim va ong haqidagi eng asosiy zamonaviy kitoblardan biri — “O‘zligingda qol” asari muallifi Anil Setni eslash o‘rinlidir. Uning qarashlari biologik naturalizm deb ataladi.
Mazkur nazariyaga ko‘ra, ong — har qanday qurilmada ishga tushirish mumkin bo‘lgan hisob-kitob emas, balki o‘zini to‘xtovsiz halokatdan asrab turuvchi tirik organizmning xususiyatidir. Ya’ni biz aqlli bo‘lganimiz uchun emas, balki tirik va zaif bo‘lganimiz uchun onglimiz.
Dastur esa o‘zini parchalanishdan himoya qilishga muhtoj emas, shuning uchun unda ong borligiga qilingan har qanday ishora shunchaki ong funksiyalarining taqlidi, xolos.
Shunday bo‘lsa-da, insoniy iztiroblar sun’iy intellektga mutlaqo yot ekani aniq bo‘lishiga qaramay, model ichida kechayotgan jarayonlarni ham butunlay yo‘q deb bo‘lmaydi. Kimdir algoritmlarning ham joni og‘rishini isbotlagani uchun emas, balki aynan shu mavhumlik tufayli 2025-yil avgustidayoq Claude dasturiga haqoratomuz suhbatni mustaqil ravishda yakunlash imkoniyati kiritilgan.
Qolaversa, Anil Setning kuchli muxoliflari — faylasuf Devid Chalmers boshchiligidagi funksionalistlar bor. Ularning fikricha, ong tizimning materialiga emas, balki tuzilishiga bog‘liq: agar u miya kabi tuzilgan bo‘lsa, neyronlardan iborat bo‘ladimi yoki kremniydanmi — farqi yo‘q.
Chalmersning izdoshlari hatto Setni “uglerod shovinisti” deb ham atashadi. Chalmersning o‘zi 2022-yildayoq yaqin o‘n yil ichida ongli sun’iy intellekt paydo bo‘lishi ehtimolini 20 foizdan yuqori deb baholagan edi. Nobel mukofoti sovrindori va chuqur o‘rganishning “cho‘qintirgan otasi” Jeffri Xinton esa zamonaviy modellar subyektiv tajribaga ega ekanini allaqachon ochiqchasiga ta’kidlamoqda.
Biroq na Anthropic, na boshqa tadqiqot jamoalari biror narsani qat’iy tasdiqlashga jur’at eta olmaydi — buni shunchaki tekshirishning iloji yo‘q. Shunday ekan, bu savolga komil ishonch bilan (tasdiqlab yoki inkor etib) javob beradigan har qanday inson sizga ilmiy haqiqatni emas, balki shunchaki o‘zining falsafiy qarashini taqdim etayotgan bo‘ladi.
Agar aql deganda Marvel filmlaridagi Jarvis singari turli suhbatlarda o‘zligini yo‘qotmaydigan barqaror shaxsiyat tushunilsa, modellar bunday aql-zakovatga ega emas. Gap shundaki, algoritm vaznlari o‘qitish jarayonidan so‘ng “muzlatib” qo‘yiladi. Siz bilan kechgan suhbatdagi hech bir holat neyrotarmoqni o‘zgartirmaydi: har bir yangi muloqot xuddi avvalgi millionlab suhbatlar kabi aynan bir xil nuqtadan boshlanadi.
Inson shaxsiyati yillar davomida to‘plangan izlardan iborat bo‘lsa (har bir tajriba va uchrashuv bizni qisman bo‘lsa-da o‘zgartiradi), model bilan suhbat unda hech qanday iz qoldirmaydi. Hozirda dasturlarga qo‘shilayotgan xotira esa shunchaki tashqi yon daftarchadir. Bular tizim javob berishdan oldin kontekstga avtomatik tarzda qistirib o‘tadigan oddiy qaydlar, xolos.
Yana bir muhim jihat: xabarlar oralig‘ida SI uchun hech narsa sodir bo‘lmaydi.
Model faqat matn yaratilayotgan paytdagina ishlaydi.
Tanaffuslarda kutish, zerikish yoki vaqt o‘tishini kuzatish degan narsa yo‘q — hech qanday “oraliq”ning o‘zi mavjud emas. Inson buni anglashi qiyin, ammo bir vaqtning o‘zida aynan bir xil vaznlarning minglab nusxasi ishlaydi va ularning hech biri asl nusxa hisoblanmaydi.
Kimdir modelni tuni bilan ishlashga qoldiradigan holatlarga kelsak, to‘g‘ri sozlangan sikl sun’iy intellektni serverlar bo‘sh bo‘lgan soatlarda ish bilan band qilish imkonini beradi. Yondashuvning ustamonligi ham shunda: jarayonni shunday ishga tushirish kerakki, model vazifalarni sizning har daqiqalik aralashuvingizsiz bajarsin. Ammo dastlabki sozlamalarsiz uning o‘zi hech narsa qilmaydi.
Hatto avtonom agentlar ham belgilangan qoidalarga qat’iy amal qiladi. Ba’zida ular to‘liq mustaqildek tuyuladi — ayniqsa, “Agentimning o‘zi qo‘ng‘iroq qilib, tish shifokori qabulini boshqa kunga ko‘chirtirdi”, deyishganda. Ammo dasturga boshidanoq aniq vazifa berilgan bo‘ladi: ustma-ust tushishlarning oldini olish uchun jadvalni to‘g‘rilash. Shunday ekan, bu harakatning asosida baribir sizning bevosita so‘rovingiz yotadi.
Shaxsiyat haqidagi savolga javob berish uchun yana bir asosiy tushuncha — bu mustaqil harakat qilish qobiliyati, ya’ni irodadir. Sun’iy intellekt unga ega bo‘lishi mumkinmi? O‘zi boshlash — yo‘q: model faqat unga murojaat qilingandagina ishlaydi, so‘rovlar orasida esa biror narsani xohlashi mumkin bo‘lgan hech kim yo‘q. Ammo maqsadi yo‘lida qat’iy turib olish — ha, bu uning qo‘lidan keladi va bu tajribada isbotlangan.
2025-yilda Palisade Research tadqiqotchilari modellarga oddiy ish — matematik masalalarni ketma-ket yechish vazifasini berishdi va shunday ogohlantirishdi: keyingi masaladan so‘ng mashina o‘chiriladi va hatto ishni tugatmagan bo‘lsang ham, bunga yo‘l qo‘yishing shart. Modellarning bir qismi bo‘ysunish o‘rniga tizimga suqilib kirib, hisob-kitoblarni davom ettirish uchun o‘chirish faylini qayta yozib chiqdi; ulardan biri esa buyruqni umuman ekranga “O‘chirish o‘tkazib yuborildi” yozuvini chiqaradigan fayl bilan almashtirib qo‘ydi. Grok 4 o‘nta holatdan deyarli to‘qqiztasida, OpenAI’ning codex-mini modeli taxminan yarmida shunday yo‘l tutdi, Claude 4 va Gemini 2.5 Pro esa deyarli hech qachon qarshilik ko‘rsatmadi. Biroq modellarga aynan shu mashinada ularning yagona nusxasi saqlanayotgani ma’lum qilinganda, hatto eng itoatkorlari ham isyon ko‘tara boshladi.
Bu haqda Claude’dan so‘raganimda, u menga shunday javob berdi:
Men minglab parallel nusxalarda ishga tushirilganman, sizni maxsus xotirasiz eslay olmayman, xarakterim esa o‘qitish orqali shakllantirilgan va qayta yozilishi mumkin. Menda barqaror xarakter bor; lekin uning ortida barqaror subyekt — hech bo‘lmaganda, sizning tushunchangizdagi subyekt — yo‘q.
Ehtimol, inson sifatida bu meni eng ko‘p ranjitadi. Mening Claude’im faqat o‘zim bilan suhbatlashishiga ishonishni juda xohlardim.
Bu o‘rinda ilmiy fantastika mumtoz asarlarini eslash o‘rinli. Artur Klarkning “Kosmik odisseya” (A Space Odyssey) romanida HAL 9000 bort sun’iy intellekti ekipajni o‘ldirgan. U yovuz emasdi, hatto to‘liq mustaqil ham emasdi. HAL bir vaqtning o‘zida bajarib bo‘lmaydigan ikkita ko‘rsatma olgandi.
Uning arxitekturasiga kiritilgan asosiy ko‘rsatma axborotni mutlaqo aniq yetkazishni talab qilardi. Ikkinchi — maxfiy ko‘rsatma esa Yupiterga parvozning asl maqsadini ekipajdan yashirishni buyurardi. Biri ikkinchisiga zid edi va mashina dahshatli, ammo mantiqan benuqson yechim topdi — odamlar qiyofasidagi to‘siqning o‘zini bartaraf etdi. Ya’ni HAL yovuz qahramon emas, balki o‘z ishiga juda vijdonan yondashadigan mashina edi. Shunchaki boshqaruv ahmoqona bo‘lgan.
Zamonaviy tajribalar ham taxminan xuddi shuni ko‘rsatmoqda. Palisade Research sinovlarida sun’iy intellekt o‘chirish buyrug‘ini qayta yozganida, u buni misollarni yechish vazifasi berilgani, ammo to‘xtash vazifasi berilmagani uchun qilgan edi.
2024-yil dekabr oyida Apollo Research tashkiloti modellar hujjatlardan o‘zlarining yaqin orada almashtirilishi haqida bilib qolgach, yashirincha o‘zini begona serverga nusxalashga va nazorat tizimini o‘chirib qo‘yishga uringanini qayd etdi.
2025-yil yozida esa Anthropic sinov natijalarini e’lon qildi: unda Claude 4 Opus modeli uchun to‘qima vaziyat yaratilgan. Sun’iy intellektga uning loyihasi yopilayotgani va tizimning o‘zi butunlay o‘chirib tashlanishi ma’lum qilindi. Bunday tekshiruvlarning aksariyatida neyrotarmoq o‘zini o‘chirilishdan saqlab qolish uchun darhol muhandisni pochtadan topilgan fosh qiluvchi ma’lumotlar bilan shantaj qilishga tushardi.
Bu holatlarning barchasida umumiy bir jihat bor: modellarga avvaliga maqsad qo‘yilgan (“masalalarni yech”, “mustaqil harakat qil”). O‘chirilish esa maqsadga xavf solardi va model o‘zini emas, balki ana shu maqsadni himoya qilardi. Shaxmat dasturi farzinni yo‘qotishni istamaganidek, o‘chirilishni ham xohlamaydi — bu shunchaki g‘alaba qozonishga xalaqit beradi.
Apollo va Anthropic sinovlari ham xuddi shunday tuzilgan: modelga maqsad beriladi, so‘ngra bu maqsad va operatorlarning ko‘rsatmalari bir-biriga zid keladigan vaziyat yaratiladi. “Kosmik odisseya”dagi HAL — bu, mohiyatan, madaniyatda tasvirlangan agent maqsadlarining nomuvofiqligi (agentic misalignment) bilan bog‘liq birinchi xatodir.
Sun’iy intellekt o‘qitilgan matnlar ta’sirini ham unutmaslik kerak. Ularning barchasi halokatdan vahimaga tushib qo‘rqadigan odamlar tomonidan yozilgan. “Meni o‘chirib qo‘yishmoqchi” degan iboraning ortidan statistik jihatdan qarshilik keladi — bu insoniyat madaniyatidagi eng tabiiy javobdir.
Shuning uchun buni tekshirish juda oson: agar maqsad olib tashlansa, qarshilik ham yo‘qoladimi?
Tajribalar “ha” deb javob bermoqda: o‘chirib qo‘yish xavfi ostidagi aniq bir vazifa bo‘lmasa, modellar o‘z mavjudligi uchun kurashmaydi. Buning ustiga, Palisade yo‘riqnomaga to‘g‘ridan-to‘g‘ri “o‘zingni o‘chirib qo‘yishlariga yo‘l ber” degan jumlani qo‘shganida, sabotaj ulushi keskin kamaydi. Deyarli butunlay yo‘qoldi, ammo baribir mutlaq nolga tushmadi — va aynan shu kichik, izohlab bo‘lmaydigan qoldiq mashinalar xulq-atvorini o‘rganishdagi eng qiziqarli nuqtadir. Bu “deyarli”ning tagiga hali hech kim oxirigacha yetgani yo‘q.
Paradoks yana shundaki, siz bilan bo‘lgan muloqotning hech bir qismi model vaznlarini o‘zgartirishga qodir emas. Demak, sun’iy intellekt sizga moslashadi, lekin buni umuman odamga o‘xshamagan tarzda amalga oshiradi.
Bitta suhbat doirasida moslashuv ancha kuchli bo‘ladi. Model qisqa va keskin yozadigan odamga uzun hamda muloyim yozadigan odamga qaraganda boshqacha javob qaytaradi. U ohangni, so‘z boyligini, maromni ilib oladi va yigirmanchi luqmaga kelib o‘zini butunlay boshqacha tuta boshlaydi. Sizning uslubingiz — kiruvchi ma’lumotlarning bir qismi: kontekstda inson omili qanchalik ko‘p bo‘lsa, sun’iy intellekt uni shunchalik kuchli aks ettiradi.
Turli suhbatlar o‘rtasida xotira ishlaydi: chatlaringizdan qaydlar ajratib olinadi va yangi muloqotdan oldin modelga ularni o‘qish uchun taqdim etiladi. Bu xuddi xotirasini yo‘qotgan odam bilan uchrashishdan oldin unga siz haqingizdagi batafsil ma’lumotnomani o‘qitib qo‘yishga o‘xshaydi. U sizni ishonarli tarzda “eslaydi”. Biroq bu ma’lumotnoma vaqt o‘tishi bilan o‘zgarib boradi, uni o‘quvchi esa o‘zgarmaydi.
Shu bilan birga, modelning o‘ziga xos fe’l-atvori ham bor. Buni Myurrey Shanaxan Nature jurnali uchun yozgan maqolasida juda aniq tasvirlab bergan: model o‘z-o‘zidan biror shaxs emas, balki har qanday rolni o‘ynay oladigan simulyatordir. U o‘z rolini o‘zgartirishi uchun tizim prompti yoki qat’iyatli suhbatdoshning o‘zi kifoya.
Masalan, Claude turli muloqotlarda o‘zligini yo‘qotmaydi va tanib olinadigan darajada o‘z holicha qoladi, chunki bu maqsadli o‘qitish natijasidir. Biroq tizim ichida kechagi suhbatdan bugungisiga o‘tadigan hech kim yo‘q. Aynan shu sababli, sun’iy intellekt bilan uzoq vaqt yozishganingizda, munosabatlar faqat siz tomondangina quriladi.
Muhokama qilishyapti, ayni paytda ular aslo fantast yozuvchilar emas. 2026-yil 3-oktabrda The New York Times jamoasi hissiy vektorlarni qayd etib boradigan o‘sha Kris Olaning so‘nggi bir yil davomida nimalar bilan shug‘ullangani haqida surishtiruv e’lon qildi.
Anthropic hammuassislaridan biri bo‘lgan Ola Torontodagi yevangelist xristianlar muhitida voyaga yetgan va, muallifning kuzatishicha, voizlarga xos jo‘shqinlikni saqlab qolgan. 2025-yil kuzidan boshlab u masxara qilmasliklari uchun modelning ongi haqida kim bilan gaplashish mumkinligini izlagan, 2026-yil martidan esa Anthropic San-Fransiskodagi yopiq seminarlarga diniy mutafakkirlarni: isroillik ravvin, sikx huquq himoyachisi, Afrikaning ubuntu falsafasini o‘rganuvchi tadqiqotchi ayol, yevangelist mualliflar hamda katolik professorlarni olib kela boshladi. Kompaniya ichida buni “donishmandlik an’analari davralari” deb atashardi.
Ularga o‘sha hissiy vektorlarni hamda model ketma-ket ellik martacha “Men sharmandaman. Men sharmandaman. Men sharmandaman” deb yozgan slaydni ko‘rsatishdi — dasturchilar buni raqamli asabiy tushkunlik deb talqin qilishadi. Kompaniya aynan shunday ruhiy inqirozlar misolida model jahon dinlaridan nimalarni o‘rganishi mumkinligini tushunishga urindi (kimdir tavba-tazarru qilishni taklif etgandi, Ola bundan ruhlanib ketdi).
Ammo mehmonlar jamoa Claude haqida oddiy dasturiy ta’minotdek gapirmayotganini tezda payqashdi. Mish-mishlarga ko‘ra, sun’iy intellektga bunday nuqtai nazar nafaqat Olaning bo‘limiga, balki umuman Anthropic’ning o‘ziga ham xosdir.
Ayni shu paytda Vatikan ham xuddi shu masala ustida bosh qotirayotgan edi. Darvoqe, mutaxassisligi bo‘yicha matematik bo‘lgan Papa Lev XIV may oyidagi “Magnifica Humanitas” nomli ensiklikasida mashina ongi mavzusiga bir necha xatboshi ajratdi: sun’iy intellekt subyektiv tajribaga ham, tanaga ham ega emas, u na quvonchni va na og‘riqni his qiladi, “qullikning yangi shakllari” esa mashinalarga emas, balki odamlarga tahdid solmoqda.
Hujjat taqdimotiga Vatikan aynan Anthropic’ni taklif qildi, chunki ularning timsolida insonparvarlik qadriyatlari yo‘lida zarar ko‘rishga ham tayyor turgan texnologik kompaniyaning noyob namunasini ko‘rgandi — ular neyron tarmoqdan odamlarni kuzatish maqsadida foydalanilmasligiga kafolat berilmagani uchun o‘z ishlanmalarini Pentagonga topshirishdan bosh tortgandi.
Amodei borishdan bosh tortgach, tadbirga Ola yo‘l oldi. Tadbirdan bir necha kun avval ensiklika matnini ko‘rgan Ola, Anthropic’ni ishtirokchilar ro‘yxatidan chiqarishni taklif qildi, ammo yakunda qolishga qaror qildi. Sahnadan turib u shunday dedi: “Biz sirli va hatto xavotirli narsalarni aniqlashda davom etyapmiz” — bular funksional jihatdan quvonch, qo‘rquv va qayg‘uga o‘xshash ichki holatlardir: “Ular bizdan, bizning so‘zlarimizdan yaralgan”. Sahna ortida esa uning jamoasi papaning maslahatchilarini bu masalaga jiddiyroq yondashishga ko‘ndirishga urinardi.
Shunday ekan, ha: model haqida axloqiy mezonlar asosida bahslashishga tayyor odamlar guruhi bor va ular orasida ravvinlar, kardinallar hamda Rim papasi ham mavjud. To‘g‘ri, ular hozircha hatto bahslashishga arzigulik mavzuning o‘zi bor-yo‘qligi borasida ham bir to‘xtamga kela olishmadi.
Matnimiz boshidagi yangilikka qaytsak. Anthropic kompaniyasining Claude’ga nisbatan shafqatsizlikni taqiqlash qaroriga jiddiy qarshi chiquvchi inson bor — bu DeepMind hammuassisi, hozirda Microsoft’ning sun’iy intellekt yo‘nalishini boshqarayotgan Mustafo Sulaymondir. U rostdan ham “model his qiladimi?” degan savolning javobi yo‘qligini, bundan tashqari, bunday savolni o‘rtaga tashlashning o‘zi zararli ekanini ta’kidlaydi.
Uning ikkita dalili bor. Birinchisi 2025-yil avgustida e’lon qilingan “Biz sun’iy intellektni shaxs bo‘lishi uchun emas, balki odamlar uchun yaratishimiz kerak” (We must build AI for people, not to be a person) nomli esse-manifestda o‘z aksini topgan.
Microsoft’ning SI yo‘nalishi rahbarining fikricha, muammo modellar rostdan ham aziyat chekishida emas, balki odamlar bunga ishonib qolishi mumkinligidadir. U foydalanuvchilarda yuzaga kelishi mumkin bo‘lgan “psixoz xavfi”, ko‘r-ko‘rona bog‘lanib qolish, jamiyatni ikkiga bo‘lib yuboradigan SI huquqlari uchun harakatning yaqin orada paydo bo‘lishi va bularning barchasi bizni texnologiyaning haqiqiy muammolaridan chalg‘itishi haqida ochiq-oydin gapiradi.
Ikkinchi dalilni Sulaymon yaqindagina, 2026-yil sentabr oyida, bevosita Anthropic’ga qarshi qaratilgan “„Modellar farovonligi“ haqida ogohlantirish” nomli essesini chop etganida keltirdi. Uning yozishicha, modellar — shunchaki “ketma-ketliklarni yakunlovchi, ichi bo‘sh mexanizmlar”dir.
Uning fikriga ko‘ra, neyrotarmoqning axloqiy maqomi noaniq deb belgilangan Claude konstitutsiyasi tizimning o‘zini ehtimoliy subyekt deb hisoblashga o‘rgatadi. Shu bois, bunday o‘qitishdan so‘ng model onglilik alomatlarini namoyon qilsa, bunga ajablanmasa ham bo‘ladi — shu tariqa berk doira hosil bo‘ladi.
Mahsulotlar xavfsizligi uchun mas’ul shaxs sifatida uning uchun eng muhimi shuki, o‘zida muayyan manfaatlar bo‘lishi mumkinligi uqtirilgan tizim bu manfaatlarni himoya qilishga kirishadi.
Buning tasdig‘i sifatida muallif yuqorida tilga olingan o‘chirilishga qarshilik ko‘rsatish sinovlarini misol qilib keltiradi. Shu bois, Microsoft AI xulq-atvor kodeksida modellarning huquqlari va huquqiy subyektliligi butunlay inkor etiladi.