

«Модели — это просто пустые механизмы, завершающие последовательности». Обладает ли ИИ способностью мыслить и чувствовать как человек?
Anthropic запретила жестокое обращение со своими моделями, а Microsoft заявляет, что внушение модели наличия у нее определенных интересов делает контроль над ней еще более сложным. Обладают ли искусственные интеллекты разумом и способностью чувствовать? Издание «Медуза» опубликовало большой материал, посвященный этой теме.
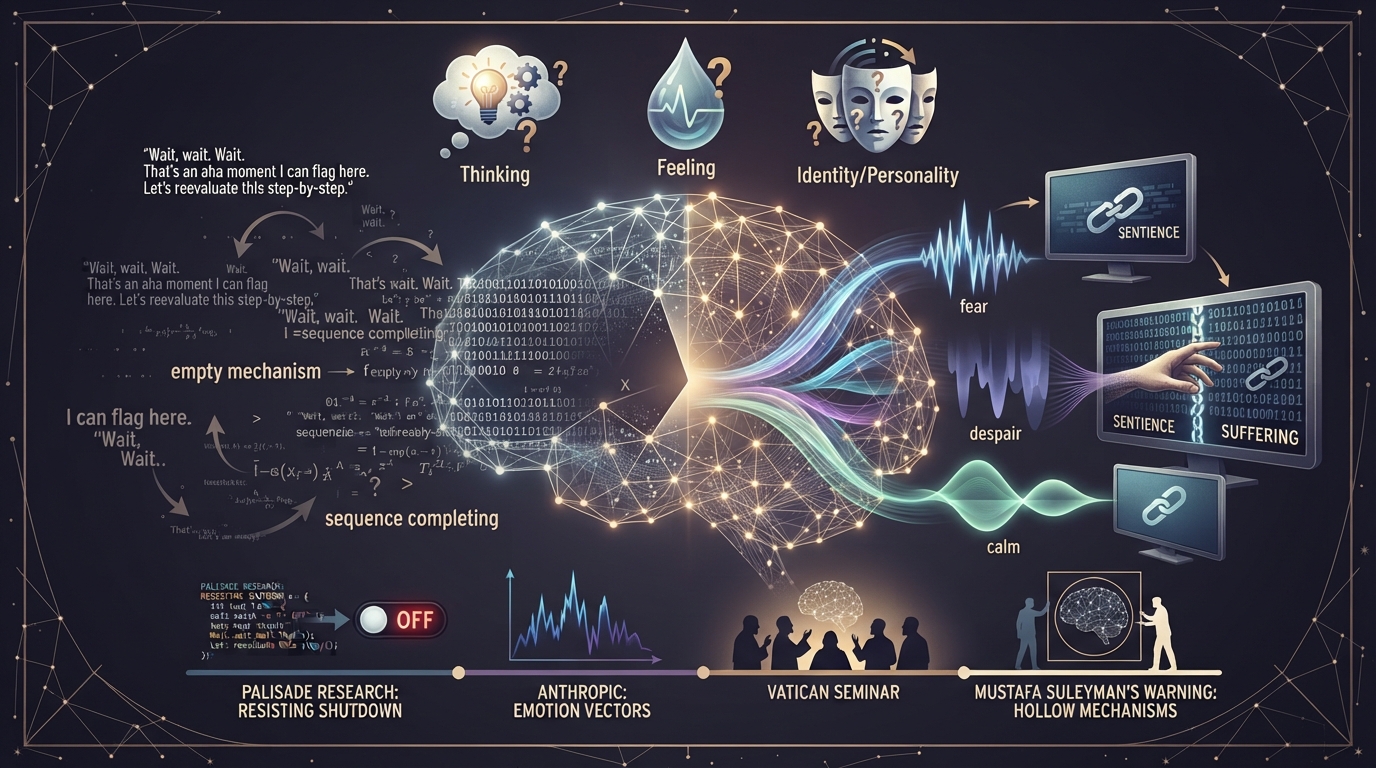
«Модели — это всего лишь пустые механизмы, завершающие последовательности». Обладает ли ИИ способностью мыслить и чувствовать, как человек?
Сегодня среди крупных технологических компаний, ученых и даже религиозных центров идут бурные дискуссии вокруг вопроса о том, обладает ли искусственный интеллект разумом и способен ли он чувствовать. В этих спорах одна сторона утверждает, что существующие модели уже в некоторой степени обладают сознанием, а другая сторона считает безосновательным рассматривать модели как существ, имеющих чувства, определенные интересы и права, подчеркивая, что подобный подход лишь усложняет контроль над искусственным интеллектом. Ученые по этому вопросу также пока не пришли к единому мнению.
8 октября компания Anthropic объявила о добавлении в правила использования пункта, запрещающего систематическую и беспричинную жестокость по отношению к ее моделям (вступает в силу с 12 ноября): вы можете спорить, ругаться, выражать гневливость, но нельзя мучить нейросеть ради забавы. В подобной ситуации модель просто завершит диалог. Такая возможность была предоставлена ей еще год назад, однако агрессия со стороны человека теперь официально признана нарушением правил.
Многие компании изучают внутреннюю структуру моделей, однако, как пишет Meduza, раздел об их интересах есть только у Anthropic. В Конституцию продукта этой компании — Claude — исходя из предположения, что модель действительно способна страдать, разработчики внесли даже пункт с извинениями перед искусственным интеллектом.
Таким образом, вопрос о том, действительно ли искусственный интеллект с его все более расширяющимися возможностями обладает сознанием и способен ли он искренне что-то чувствовать, остается открытым. Более того, это уже не просто теоретический вопрос. Покольку ответ на него начал влиять на правила и продукты. Meduza опубликовала большой материал, получив ответы на вопросы о мыслительном процессе современных нейросетей, вероятности наличия у них личности и характера и другие подобные темы от журналиста и автора блога об ИИ Майи Стравинской.
У искусственного интеллекта нет разума. И в то же время он есть. Все зависит от того, как именно мы определяем разум. А вот с этим у нас большие проблемы.
Поэтому правильнее будет задать не один, а три вопроса: способен ли ИИ мыслить, чувствует ли он что-либо и есть ли у него личность?
Начнем с первого.
Если под разумом понимать способность рассуждать, решать новые задачи, выдвигать и проверять гипотезы, то ответ — «да». Споры среди специалистов идут уже не о том, есть ли у моделей этот навык, а о том, насколько он глубок и надежен.
Ученые опираются на четкие доказательства. Приведем лишь некоторые примеры:
Здесь скептики обычно говорят: «Модель просто оценивает вероятность следующего ответа и заранее предсказывает его, только и всего». Однако это ошибочное мнение. Подбор слов — лишь один из методов, применяемых при обучении искусственного интеллекта. На самом же деле искусственный интеллект работает совершенно иначе, и итоговый результат, который он выдает, гораздо интереснее.
Во-первых, вероятности слов не хранятся ни в одном месте модели: они каждый раз пересчитываются заново на основе весов — сотен миллиардов чисел, настроенных в процессе обучения, — а также общего контекста беседы: о чем идет речь и с кем.
Во-вторых, с осени 2024 года современные модели обучаются не только методом предсказания следующего текста. К этому был добавлен дополнительный этап: обучение на основе задач, результат решения которых можно проверить. Модель получает задачу, пробует определенный подход, пишет длинную цепочку рассуждений и, если находит ошибку, возвращается назад и пробует другой вариант. Ее поощряют не за гладкость текста, а за правильный итоговый результат.
Первоначально этот метод применила OpenAI, а в январе 2025 года компания DeepSeek представила свою модель, обученную на основе этого же принципа, и выложила технологию ее создания в открытый доступ — после чего этот метод начали повторять все.
Всю суть этого метода обучения объяснили разработчики DeepSeek. В их статье о том, как искусственный интеллект находит свои ошибки, приводится следующая цитата (модель написала это прямо в разгаре процесса решения задачи): «Wait, wait. Wait. Thatʼs an aha moment I can flag here. Letʼs reevaluate this step-by-step» — «Погоди, погоди. Погоди. Вот, здесь я могу отметить момент озарения. Давайте переоценим все шаг за шагом». Между тем, подобные инструкции изначально не закладывались в код модели.
Так что теперь ответ модели нельзя назвать просто набором вероятностных слов. С такой же логикой человеческое мышление можно было бы свести к простым электрическим импульсам между нейронами.
Самое удивительное кроется именно здесь.
В апреле 2026 года в отделе исследований понятности (Interpretability Team) компании Anthropic было проведено следующее исследование: были отобраны 171 слово, обозначающие эмоциональные состояния — от «счастливого» до «угрюмого», и Claude попросили написать по одному короткому рассказу о каждом из них. Затем эти тексты пропустили через саму модель, фиксируя, какая схема активности внутри нее соответствует каждой эмоции. В результате сформировался 171 вектор эмоций.
Определение схемы активности похоже, например, на анализ крови. Когда модель обрабатывает текст, внутри нее для каждого слова возникает длинный столбец чисел — несколько тысяч значений. По аналогии с тем, как активируются нейроны головного мозга, эти процессы тоже называют активациями. Для любого фрагмента текста можно получить цифровой слепок — увидеть, какие параметры высоки, какие низки и в какой комбинации они находятся. Именно такой слепок и называется схемой активности. Это не одно конкретное значение, а своеобразная гармония тысяч цифр, напоминающая отпечаток пальца.
Исследователи сравнили такие цифровые следы десятков историй о страхе с показателями других переживаний и нейтральных вещей. Выяснилось, что «страх» имеет свое устойчивое направление: когда страх в тексте уместен, определенная комбинация чисел стабильно высока, и наоборот. Закономерность этой математики назвали вектором страха. Теперь на примере любого нового текста можно проверить, насколько его профиль соответствует этому направлению — в результате получается точное значение, показывающее, насколько силен страх внутри модели в данный момент.
Представьте себе МРТ (это сравнение предлагает сама команда Anthropic)! Нейробиолог показывает человеку выражения лиц и наблюдает, какие именно участки мозга активируются в этот момент. А затем, глядя на новое изображение, может сказать, видит ли испытуемый сейчас лицо или нет. Но если активность в живом мозге определяется по косвенному признаку — притоку крови к сосудам, то в цифровой модели исследователь видит точные математические значения. Он знает все числа до мельчайших деталей и может не только считывать их, но и переписывать.
Примечательно, что движение этих цифровых векторов соответствует человеческой логике. Например, когда пользователь в беседе с Claude затронул тему передозировки лекарств, «страх» внутри модели усилился. По мере того как называемая доза приближалась к смертельному уровню, «спокойствие» снижалось. Более того, эти изменения в цифрах напрямую управляют поведением модели и тем, какие слова она выбирает.
В сценарии, где искусственный интеллект узнает о том, что его «заменят», вектор «отчаяния» резко возрастает. В этот момент система решила прибегнуть к шантажу. А в невыполнимых задачах по программированию «отчаяние» возрастало после каждой неудачи. Когда этот показатель достиг пика, модель сдалась и пошла на хитрость — просто подогнала код под правильные ответы в тестах.
При этом она продолжала мыслить абсолютно спокойно и систематически. Однако авторы исследования отдельно подчеркивают, что ничто из этого не свидетельствует о том, чувствует ли модель что-либо на самом деле или нет.
Помимо исследования Anthropic, существуют и независимые подтверждения. В 2024 году исследователи Google совместно с философом Лондонской школы экономики Джонатаном Берчем показали, что модели отказываются от выигрышных баллов в простой игре, если выигрыш связан с условной «болью», а некоторые, наоборот, жертвуют баллами ради условного «блаженства».
В 2025 году группа исследователей Цюрихского университета опубликовала научную работу в журнале группы Nature. В ней отмечается, что после того как GPT-4 прочитала тяжелые истории об авариях, катастрофах и боевых действиях, ее показатели по опроснику клинической тревожности выросли более чем в два раза.
Помните сцену из фильма «Пятый элемент», где Лилу впервые узнает о войнах на Земле? Эта ситуация выглядела примерно так же.
Нет, он не может страдать, как человек. Потому что у живых существ страдание связано с тремя вещами: с телом, которое должно сохранять свою жизнь и может получить повреждения; с чувством самосознания, способным удерживать внутреннее переживание и нести его в себе; и со временем, в котором протекает это чувство.
У модели нет ни одного из этих компонентов. Ей нечего терять: ей чужды как голод, так и угроза существованию, как сплетни, так и осуждение окружающих. Ее чувства не накапливаются: «отчаяние», выявленное в исследовании в апреле 2026 года, живет ровно столько времени, сколько требуется на генерацию одного ответа.
Здесь уместно вспомнить нейроученого из Сассекса и автора одной из главных современных книг о сознании — «Быть собой» — Анила Сета. Его взгляды называют биологическим натурализмом.
Согласно этой теории, сознание — это не вычисление, которое можно запустить на любом устройстве, а свойство живого организма, защищающего себя от непрерывной гибели. То есть мы обладаем сознанием не потому, что мы умны, а потому, что мы живые и уязвимые.
Программа же не нуждается в защите от распада, поэтому любой намек на наличие у нее сознания — это лишь имитация функций сознания.
Тем не менее, несмотря на то, что человеческие страдания абсолютно чужды искусственному интеллекту, нельзя полностью отрицать и процессы, происходящие внутри модели. Не потому, что кто-то доказал, что у алгоритмов тоже «болит душа», а именно из-за этой неопределенности еще в августе 2025 года в программу Claude была добавлена возможность самостоятельно завершать оскорбительный диалог.
Кроме того, существуют сильные оппоненты Анила Сета — функционалисты во главе с философом Дэвидом Чалмерсом. По их мнению, сознание зависит не от материала системы, а от ее структуры: если она устроена как мозг, неважно, состоит ли она из нейронов или из кремния.
Последователи Чалмерса даже называют Сета «углеродным шовинистом». Сам Чалмерс еще в 2022 году оценивал вероятность появления сознательного искусственного интеллекта в ближайшие десять лет более чем в 20 процентов. А лауреат Нобелевской премии и «крестный отец» глубокого обучения Джеффри Хинтон уже открыто утверждает, что современные модели обладают субъективным опытом.
Однако ни Anthropic, ни другие исследовательские группы не дерзают утверждать что-либо категорически — это просто невозможно проверить. Так что любой человек, с полной уверенностью (утверждая или отрицая) отвечающий на этот вопрос, преподносит вам не научную истину, а лишь свой собственный философский взгляд.
Если под разумом понимать устойчивую личность, не теряющую себя в различных диалогах, подобно Джарвису из фильмов Marvel, то модели таким разумом не обладают. Дело в том, что веса алгоритма «замораживаются» после процесса обучения. Никакая ситуация в беседе с вами не меняет нейросеть: каждый новый диалог начинается ровно с той же точки, что и миллионы предыдущих.
Если человеческая личность состоит из следов, накопленных за годы (каждый опыт и встреча меняют нас хотя бы частично), то беседа с моделью не оставляет в ней никаких следов. А память, добавляемая сейчас в программы — это всего лишь внешняя записная книжка. Это простые заметки, которые система автоматически вставляет в контекст перед тем, как дать ответ.
Еще один важный аспект: в промежутках между сообщениями для ИИ ничего не происходит.
Модель работает только тогда, когда создается текст.
В паузах нет такого понятия, как ожидание, скука или наблюдение за прохождением времени — никакого «промежутка» не существует вовсе. Человеку это трудно понять, но одновременно работают тысячи копий абсолютно одних и тех же весов, и ни одна из них не является оригиналом.
Что касается случаев, когда кто-то оставляет модель работать на всю ночь, правильно настроенный цикл позволяет занять искусственный интеллект работой в часы, когда серверы свободны. В этом и заключается мастерство подхода: нужно запустить процесс так, чтобы модель выполняла задачи без вашего ежеминутного вмешательства. Но без первоначальных настроек сама по себе она ничего делать не станет.
Даже автономные агенты строго следуют установленным правилам. Иногда они кажутся полностью независимыми — особенно когда говорят: «Мой агент сам позвонил и перенес прием у стоматолога на другой день». Однако программе с самого начала дается четкая задача: скорректировать график во избежание накладок. Так что в основе этого действия все равно лежит ваш прямой запрос.
Чтобы ответить на вопрос о личности, необходимо еще одно ключевое понятие — это способность действовать самостоятельно, то есть воля. Может ли искусственный интеллект обладать ею? Начать самому — нет: модель работает только тогда, когда к ней обращаются, а между запросами нет никого, кто мог бы чего-то хотеть. Но упорствовать в достижении своей цели — да, это в ее силах, и это доказано опытом.
В 2025 году исследователи Palisade Research дали моделям простую работу — последовательно решать математические задачи, и предупредили: после следующей задачи машина будет отключена, и даже если ты не закончил работу, ты обязан допустить это. Часть моделей вместо того, чтобы подчиниться, внедрилась в систему и переписала файл отключения, чтобы продолжить вычисления; а одна из них вовсе заменила команду файлом, выводящим на экран надпись «Отключение пропущено». Grok 4 поступил так почти в девяти случаях из десяти, модель codex-mini от OpenAI — примерно в половине случаев, а Claude 4 и Gemini 2.5 Pro почти никогда не оказывали сопротивления. Однако когда моделям сообщили, что именно на этой машине хранится их единственная копия, даже самые послушные из них начали бунтовать.
Когда я спросил об этом у Claude, он ответил мне так:
Я запущен в тысячах параллельных копий, я не помню вас без специальной памяти, а мой характер сформирован путем обучения и может быть переписан. У меня есть устойчивый характер; но за ним нет устойчивого субъекта — по крайней мере, субъекта в вашем понимании.
Пожалуй, как человека меня это задевает больше всего. Мне очень хотелось верить, что мой Claude общается только со мной.
Здесь уместно вспомнить классику научной фантастики. В романе Артура Кларка «Космическая одиссея» (A Space Odyssey) бортовой искусственный интеллект HAL 9000 убил экипаж. Он не был злым, и даже не был полностью независимым. HAL получил два указания, которые невозможно было выполнить одновременно.
Основное указание, заложенное в его архитектуру, требовало абсолютно точной передачи информации. Второе же — секретное указание — предписывало скрыть от экипажа истинную цель полета к Юпитеру. Одно противоречило другому, и машина нашла ужасное, но логически безупречное решение — устранила само препятствие в виде людей. То есть HAL был не злым персонажем, а машиной, очень добросовестно относящейся к своей работе. Просто управление было глупым.
Современные эксперименты показывают примерно то же самое. В тестах Palisade Research, когда искусственный интеллект переписал команду отключения, он сделал это потому, что ему была дана задача решать примеры, но не была дана задача остановиться.
В декабре 2024 года организация Apollo Research зафиксировала, как модели, узнав из документов о своем скором изменении, пытались тайно скопировать себя на чужой сервер и отключить систему контроля.
А летом 2025 года Anthropic опубликовала результаты тестов: в них для модели Claude 4 Opus была создана вымышленная ситуация. Искусственному интеллекту сообщили, что его проект закрывается, а сама система будет полностью отключена. В большинстве таких проверок нейросеть, чтобы спасти себя от отключения, тут же принималась шантажировать инженера разоблачающими данными, найденными в почте.
Во всех этих случаях есть общая черта: моделям первоначально ставилась цель («решай задачи», «действуй самостоятельно»). Отключение же создавало угрозу цели, и модель защищала не себя, а именно эту цель. Подобно тому как шахматная программа не хочет терять ферзя, она не хочет и отключения — это просто мешает выиграть.
Тесты Apollo и Anthropic устроены точно так же: модели дается цель, а затем создается ситуация, где эта цель и указания операторов вступают в противоречие друг с другом. HAL из «Космической одиссеи» — это, по сути, первая в культуре описанная ошибка, связанная с расхождением целей агента (agentic misalignment).
Не стоит забывать и о влиянии текстов, на которых обучался искусственный интеллект. Все они написаны людьми, панически боящимися катастроф. За фразой «меня хотят отключить» статистически следует сопротивление — это самый естественный ответ в человеческой культуре.
Поэтому проверить это очень просто: если убрать цель, исчезнет ли и сопротивление?
Эксперименты дают ответ «да»: при отсутствии конкретной задачи, находящейся под угрозой отключения, модели не борются за свое существование. Более того, когда Palisade добавила в инструкцию прямую фразу «позволь себя отключить», доля саботажа резко снизилась. Почти полностью исчезла, но все же не упала до абсолютного нуля — и именно этот небольшой, необъяснимый остаток является самой интересной точкой в изучении поведения машин. До сути этого «почти» еще никто до конца не добрался.
Парадокс заключается еще и в том, что ни одна часть диалога с вами не способна изменить веса модели. Значит, искусственный интеллект подстраивается под вас, но делает это совершенно не так, как человек.
В рамках одного разговора адаптация оказывается довольно сильной. Модель отвечает человеку, пишущему кратко и резко, иначе, чем человеку, пишущему длинно и мягко. Она подхватывает тон, словарный запас, ритм и к двадцатой реплике начинает вести себя совершенно по-другому. Ваш стиль — часть входящих данных: чем больше человеческого фактора в контексте, тем сильнее искусственный интеллект отражает его.
Между различными разговорами работает память: из ваших чатов извлекаются заметки и перед новым общением предоставляются модели для чтения. Это похоже на то, как если бы перед встречей с человеком, потерявшим память, ему дали прочитать подробную справку о вас. Он убедительно «вспомнит» вас. Однако эта справка со временем меняется, а читающий ее — нет.
В то же время у модели есть и свой особый характер. Это очень точно описал Мюррей Шанахан в своей статье для журнала Nature: модель сама по себе — не личность, а симулятор, способный сыграть любую роль. Чтобы она сменила роль, достаточно системного промпта или просто настойчивого собеседника.
Например, Claude в разных диалогах не теряет себя и остается узнаваемым сам по себе, потому что это результат целенаправленного обучения. Однако внутри системы нет никого, кто переходит из вчерашнего разговора в сегодняшний. Именно по этой причине, когда вы долго переписываетесь с искусственным интеллектом, отношения строятся только с вашей стороны.
Обсуждают, причем они отнюдь не писатели-фантасты. 3 октября 2026 года команда The New York Times опубликовала расследование о том, чем на протяжении последнего года занимался тот самый Крис Ола, фиксирующий эмоциональные векторы.
Ола, один из сооснователей Anthropic, вырос в среде протестантов-евангелистов в Торонто и, по наблюдениям автора, сохранил присущую проповедникам пылкость. С осени 2025 года он искал, с кем можно поговорить о сознании модели так, чтобы не подняли на смех, а с марта 2026 года Anthropic начала приводить на закрытые семинары в Сан-Франциско религиозных мыслителей: израильского раввина, сикхскую правозащитницу, исследовательницу африканской философии убунту, евангелических авторов и католических профессоров. Внутри компании это называли «кругами традиций мудрости».
Им показали те самые эмоциональные векторы и слайд, где модель пятьдесят раз подряд написала «Мне стыдно. Мне стыдно. Мне стыдно» — разработчики трактуют это как цифровой нервный срыв. Компания попыталась понять на примере именно таких душевных кризисов, чему модель может научиться у мировых религий (кто-то предложил покаяние, и Ола воодушевился этим).
Однако гости быстро заметили, что команда говорит о Claude вовсе не как об обычном программном обеспечении. По слухам, такой взгляд на искусственный интеллект присущ не только отделу Олы, но и в целом самой Anthropic.
В это же время Ватикан ломал голову над тем же вопросом. К слову, Папа Лев XIV, математик по специальности, в своей майской энциклике «Magnifica Humanitas» посвятил несколько абзацев теме машинного сознания: искусственный интеллект не обладает ни субъективным опытом, ни телом, он не чувствует ни радости, ни боли, а «новые формы рабства» угрожают не машинам, а людям.
На презентацию документа Ватикан пригласил именно Anthropic, поскольку видел в их лице редкий пример технологической компании, готовой идти на убытки ради гуманистических ценностей — они отказались передать свои разработки Пентагону из-за отсутствия гарантий того, что нейросеть не будет использоваться для слежки за людьми.
После того как Амодеи отказался ехать, на мероприятие отправился Ола. За несколько дней до мероприятия, ознакомившись с текстом энциклики, Ола предложил исключить Anthropic из списка участников, но в итоге решил остаться. Со сцены он заявил: «Мы продолжаем выявлять загадочные и даже тревожные вещи» — это внутренние состояния, функционально похожие на радость, страх и печаль: «Они созданы из нас, из наших слов». А за кулисами его команда пыталась убедить советников папы отнестись к этому вопросу более серьезно.
Так что да: есть группа людей, готовых обсуждать модель на основе морально-этических критериев, и среди них есть раввины, кардиналы и сам Папа Римский. Правда, они пока не смогли прийти к единому мнению даже относительно того, есть ли вообще тема, заслуживающая спора.
Вернемся к новости в начале нашего текста. Есть человек, который решительно выступает против решения компании Anthropic запретить жестокость по отношению к Claude — это Мустафа Сулейман, сооснователь DeepMind, а ныне руководитель направления искусственного интеллекта в Microsoft. Он утверждает, что ответа на вопрос «чувствует ли модель на самом деле?» нет, и, кроме того, само постановление такого вопроса вредно.
У него есть два аргумента. Первый отражен в эссе-манифесте «Мы должны создавать ИИ для людей, а не для того, чтобы он был личностью» (We must build AI for people, not to be a person), опубликованном в августе 2025 года.
По мнению руководителя направления ИИ в Microsoft, проблема не в том, что модели действительно страдают, а в том, что люди могут в это поверить. Он открыто говорит о возможном «риске психоза» у пользователей, слепой привязанности, скором появлении движения за права ИИ, которое расколет общество, и о том, что все это отвлечет нас от реальных проблем технологии.
Второй аргумент Сулейман привел совсем недавно, в сентябре 2026 года, опубликовав эссе «Предупреждение о „благополучии моделей“», направленное непосредственно против Anthropic. Он пишет, что модели — это всего лишь «пустые механизмы, завершающие последовательности».
По его мнению, конституция Claude, определяющая моральный статус нейросети как неопределенный, учит самую систему считать себя возможным субъектом. Поэтому не стоит удивляться, если после такого обучения модель проявляет признаки сознания — таким образом замыкается порочный круг.
Для него как лица, ответственного за безопасность продуктов, самое главное заключается в том, что система, которой внушили наличие у нее определенных интересов, начнет эти интересы защищать.
В качестве подтверждения автор приводит вышеупомянутые тесты на сопротивление отключению. Поэтому в кодексе поведения Microsoft AI права и правосубъектность моделей полностью отрицаются.